

工业和信息化部教育与考试中心 (AI大模型全栈技术)职业能力课程介绍
一、课程背景
大模型在企业中的落地是一条从模型接入到交付运维的完整链路,涵盖主流大模型API调用、私有化与专有化部署、检索增强生成(RAG)与向量知识库构建、多框架智能体(Agent)开发、模型上下文协议(MCP)工具接入、模型微调与评测等环节。链路长、协作点多,使单一的前端、后端或算法背景难以独立支撑项目交付,“懂模型、能工程、会交付”的复合型人才由此成为市场稀缺资源。
(一)产业需求与岗位缺口
从产业侧看,“人工智能+”行动深入推进,央企国企与地方政府的大模型私有化部署需求明显增长,智能体开发、大模型应用开发等岗位需求持续走高。多数传统开发、算法与运维人员具备单点技能,但缺少把模型能力封装为稳定服务的经验,岗位供给与用人要求之间存在结构性缺口,需要通过体系化训练补齐全栈工程能力。
(二)合规要求抬高技术门槛
金融、政务、制造等行业通常不能将核心数据直接送往公有云,需要在本地化或专有化部署前提下完成模型接入、检索增强与智能体调度,并在权限、审计、监控等方面满足内控与数据安全要求。能够把合规约束转化为可落地工程方案的工程师更受用人单位重视,这也是本课程强调“全栈”而非单一提示词技巧的原因。
(三)标准支撑与人才评价
数字人才的能力建设正在获得统一的标准参照,国家标准GB/T 47640—2026《数字化转型 数字人才技术能力和培养要求》将于2026年11月1日起实施,为相关技术能力框架与培养要求提供参考依据。本课程将岗位真实能力要求与职业能力评价相结合,使学习产出更贴近用人岗位需要。
二、培养体系与课程内容
课程以“从模型调用到系统交付”为主线,按照由基础到架构的顺序递进组织教学模块,帮助学员在掌握原理的同时形成可运行、可交付的工程能力。
(一)培养目标
培养能够基于主流大模型构建企业级应用的工程技术人员,使其具备大模型API调用与私有化部署、向量知识库与RAG应用构建、多框架智能体开发与工具链编排、模型微调与效果评测等方面的完整链路实践能力,并具备在不同基座模型之间迁移方案的工程素养。
(二)课程大纲
课程核心模块、关键技术方向与对标岗位能力如下。
模块 1:大模型基础与底层原理
1. 生成式 AI 与大模型发展脉络、国内外主流大模型生态(开源 / 闭源、国产模型)
2. Transformer 架构详解:自注意力、多头注意力、位置编码、Encoder-Decoder
3. 预训练、上下文学习、少样本 / 零样本、思维链 CoT、自一致性
4. 模型参数、上下文窗口、幻觉、上下文窗口衰减、模型局限与风险
5. 对齐技术:RLHF、DPO、ORPO、红队测试、安全对齐基础
6. 多模态大模型原理:图文、语音、视频理解基础
模块 2:开发环境与 Python 工程基础
1. Python 科学计算环境:PyTorch、CUDA 环境搭建、GPU 环境排查
2. Jupyter、Docker、Linux 基础命令、GPU 显存监控
3. 开源模型 Hugging Face 平台使用、模型下载、权重格式介绍
4. 大模型 API 调用:OpenAI 兼容接口、国产大模型 API、限流、异步调用
模块 3:大模型训练数据工程(数据是核心)
1. 训练数据分类:预训练数据、SFT 指令数据、偏好数据
2. 数据清洗、去重、过滤、脱敏、格式转换(ShareGPT、Alpaca 格式)
3. 数据标注规范、自动标注工具、数据质量评估
4. 私有行业文档处理:PDF、Word、Excel、扫描件解析、文档分块策略
模块 4:大模型微调与对齐实战
1. 微调方案对比:全参数微调、LoRA、QLoRA、Adapter
2. 微调框架:PEFT、TRL、Axolotl 实操
3. SFT 监督微调完整流程、参数调优、训练日志、loss 分析
4. DPO 直接偏好优化实战、偏好数据集构建
5. 模型量化:GGUF、GPTQ、AWQ 量化原理与实操
6. 微调常见坑:过拟合、灾难性遗忘、训练不稳定解决
模块 5:向量数据库与 RAG 检索增强生成(企业最常用)
1. 向量嵌入原理、Embedding 模型选型、文本向量化
2. 主流向量库:Chroma、FAISS、Milvus、Qdrant 部署与使用
3. 文档切片、分块策略、重叠窗口、分层索引
4. RAG 全链路:文档解析→向量化→入库→召回→重排→Prompt 组装
5. RAG 优化:混合检索、关键词检索 + 向量检索、多路召回、幻觉抑制
6. 私有知识库权限隔离、增量更新、知识库版本管理
模块 6:AI Agent 智能体、工具调用与工作流开发
1. Agent 核心范式:ReAct、Plan-Solve、Self-Ask
2. LangChain / LlamaIndex 框架体系、Chain、Agent、Tools
3. 工具调用开发:代码解释器、数据库查询、API 插件、MCP 工具协议
4. Dify 平台实战:可视化工作流、知识库、Agent、应用发布
5. 多 Agent 协作、记忆模块、短期 / 长期记忆
6. 数字员工、智能客服、内部问答助手案例开发
模块 7:大模型私有化部署与工程运维
1. Ollama 快速本地部署、模型管理、API 服务
2. vLLM、TGI 高性能推理部署、连续批处理 PagedAttention
3. 单机部署、多机多卡部署、模型服务集群
4. 推理优化:量化、KV 缓存、流式输出、并发控制
5. 权限、鉴权、日志、审计、流量管控、内网隔离方案
6. 监控体系:GPU 利用率、延迟、token 消耗、错误告警
模块 8:模型评测、安全与合规
1. 大模型评测维度:事实性、推理、幻觉、安全、鲁棒性
2. 自动评测框架、人工评测规范、评测数据集
3. 大模型风险:提示注入、越狱、数据泄露、版权风险
4. 行业合规:数据出境、隐私、内容安全、等保相关要求
5. 提示词攻防、输入过滤、输出审查
模块 9:行业项目实战(结业综合项目)
可选方向:
- 企业私有知识库问答系统
- 内部业务智能 Agent(对接 OA / 数据库)
- 行业轻量化微调模型(法务、制造、政务、医疗辅助)
- 多模态文档智能解析系统
- 私有化大模型服务平台搭建
三、培训对象
课程主要面向软件工程师、算法工程师、全栈与后端开发人员、运维工程师、数据分析师等希望参与企业人工智能项目落地的技术从业者,同时适合计算机相关专业应届毕业生、拟向人工智能方向转型的跨行业人员,以及需要了解技术合规与落地能力的管理人员和创业者。
四、证书颁发与查询
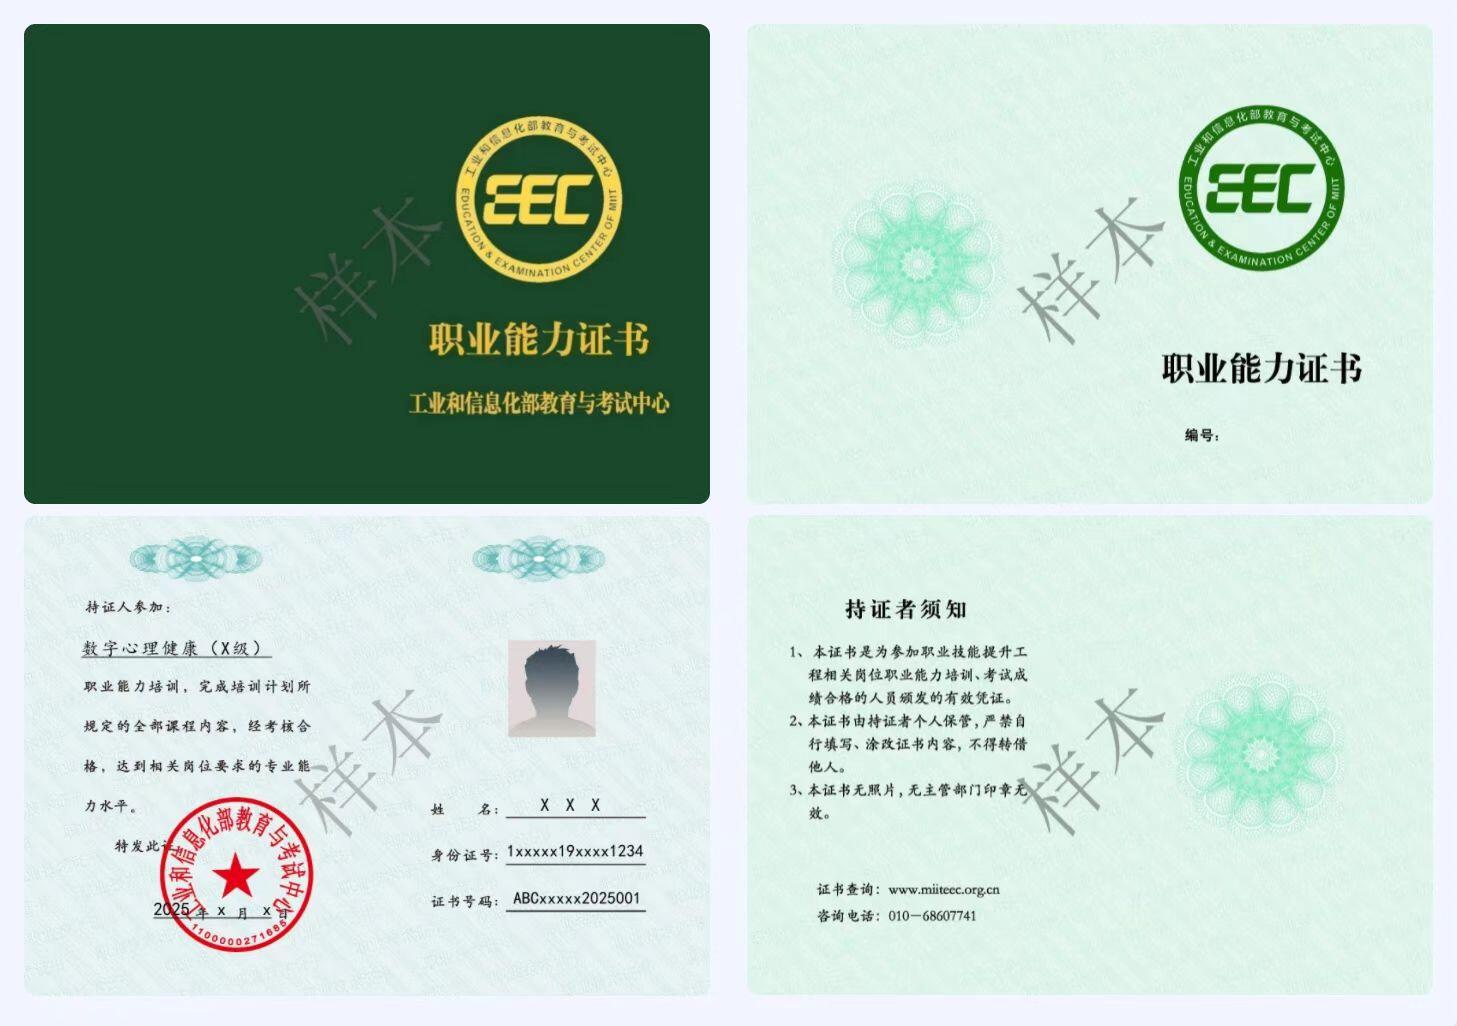
学员完成规定培训并通过考核后,由工业和信息化部教育与考试中心统一颁发《AI大模型全栈技术(高级)》职业能力证书,证书长期有效,证书信息可登录工业和信息化部教育与考试中心官网(证书查询栏目)核验。
五、课程价值与发展方向
该课程的价值主要体现在三个方面:
一是为从业者提供系统补齐大模型全栈工程能力的路径,避免零散学习带来的能力断层;
二是以权 威发证主体的职业能力证书作为能力凭证,便于用人单位在招聘、晋升、内部评级与绩效评定中识别技能人才水平,也可作为部分项目招投标等场景的参考材料之一;
三是在模型密集迭代的背景下,帮助从业者形成可迁移的工程方法,降低对单一模型或单一厂商的依赖。
总体来看,“AI大模型全栈技术”职业能力课程紧扣企业大模型应用落地难的实际痛点,以岗位能力为出发点组织教学内容,以专业职业能力评价检验学习成效,适合希望在人工智能工程方向建立职业竞争力的技术人员系统学习。